Guía profesional del Commander Híbrido en operaciones
Esta guía explica, de forma objetiva y práctica, qué es un Commander Hibrido y cómo evaluar su implementación en entornos operativos. A partir de antecedentes técnicos y de buenas prácticas del sector, se analizan criterios clave: arquitectura híbrida, confiabilidad, seguridad, compatibilidad, mantenimiento y estrategia de adopción progresiva en organizaciones.
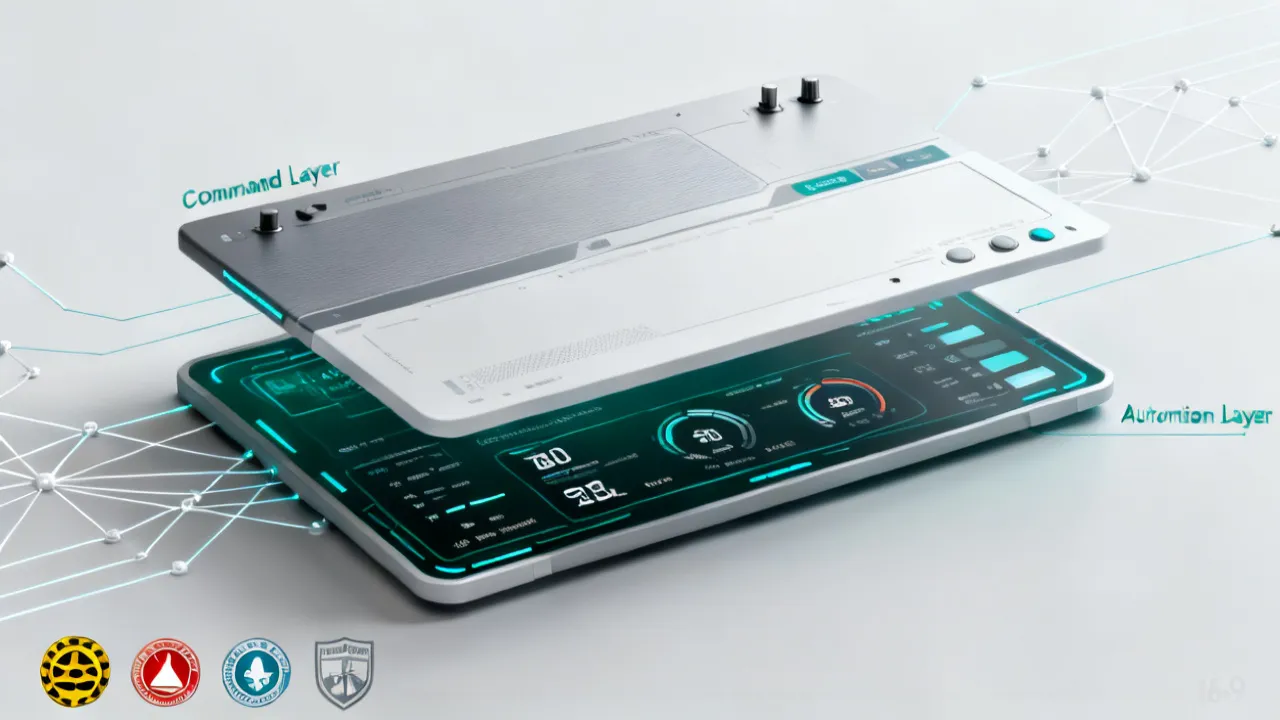
Panorama crítico: por qué importa el “Commander Hibrido” en la operación
El Commander Hibrido suele describirse como una solución de mando y control con enfoque híbrido: combina capacidades de gestión (orientadas a decisiones, coordinación y supervisión) con elementos de automatización y/o integración técnica para sostener la continuidad operativa. En términos prácticos, su valor aparece cuando una organización necesita coordinar múltiples funciones, reducir variabilidad en la respuesta y mantener trazabilidad sin sacrificar flexibilidad operativa.
Para evaluar cualquier Commander Hibrido, el punto de partida no es “qué tan llamativo” es el panel o la interfaz, sino qué problemas resuelve y cómo se comporta bajo condiciones reales: cambios de demanda, fallas parciales, picos de actividad, tiempos de respuesta exigentes y requisitos de seguridad. Un enfoque profesional prioriza la coherencia del diseño, la capacidad de integración con sistemas existentes y el ciclo de vida (instalación, operación, monitoreo, mantenimiento y eventual reemplazo).
En muchas organizaciones, la conversación sobre “mando y control” se vuelve un debate de herramientas: dashboards, tableros, reglas configurables o integraciones con servicios. Pero lo verdaderamente determinante es el comportamiento del sistema como orquestador: cómo interpreta eventos, cómo ejecuta transiciones de estado, qué hace cuando faltan datos, cómo reintenta o se degrada, y cómo se audita cada decisión. Un Commander Hibrido no es simplemente una capa que “gestiona”; es una pieza que, bien diseñada, reduce el error humano y acelera el flujo de trabajo; mal diseñado, amplifica fallas, oculta la causa raíz y vuelve frágil la operación.
Qué significa “híbrido” en un Commander Hibrido (y qué no significa)
En la práctica, “híbrido” puede referirse a distintos niveles de combinación. Para evitar confusiones, conviene separar tres dimensiones que suelen mezclarse en el discurso comercial:
- Híbrido funcional: una misma plataforma coordina funciones manuales y automáticas (o semiautomáticas).
- Híbrido técnico: integración entre tecnologías distintas (por ejemplo, datos operativos, señales de proceso, herramientas de gestión o capas de comunicación).
- Híbrido organizacional: soporte para roles y flujos de aprobación con interacción humana cuando corresponde.
Un Commander Hibrido bien diseñado no busca reemplazar por completo a las personas, sino hacer más consistente el proceso de decisión y operación. Si la “hibridación” termina en complejidad innecesaria (demasiadas configuraciones, dependencias frágiles o falta de trazabilidad), el resultado suele ser el contrario: más esfuerzo de mantenimiento y mayor probabilidad de errores operativos.
Un punto importante: “híbrido” no significa “capaz de todo” o “suficientemente flexible para cualquier caso”. Significa que el sistema está construido con contratos de comportamiento claros entre componentes: qué puede automatizar, qué requiere verificación, cómo maneja excepciones y cómo vuelve a un estado consistente. En términos de ingeniería, la “hibridación” exitosa es aquella en la que las fronteras entre lo automático y lo humano son explícitas, testeables y gobernadas.
También hay un malentendido común: creer que el componente “automático” es el centro del valor. En realidad, muchas veces el centro del valor es la coordinación: el Commander Hibrido define el flujo completo, decide qué información es necesaria para avanzar, y asegura que cada acción quede registrada. La automatización controlada es solo la forma de ejecutar parte de ese flujo con consistencia.
Arquitectura y componentes: dónde se define la confiabilidad
Desde una perspectiva de experto, la confiabilidad no se “declara”: se diseña. Un Commander Hibrido típicamente requiere al menos estas capas:
- Orquestación de mando: define estados, prioridades, reglas de transición y flujos de trabajo.
- Integración: conecta con fuentes internas (sistemas de gestión, registros, inventarios, herramientas de operación) y, si aplica, con terceros.
- Automatización controlada: ejecuta acciones con límites, verificaciones y condiciones de seguridad.
- Monitoreo y observabilidad: métricas, logs, alarmas y capacidad de diagnóstico.
- Gestión de cambios: versionado, procedimientos de actualización y reversión.
El punto crítico es que estas capas deben operar con un modelo claro de responsabilidad. Si la plataforma “decide” sin trazabilidad o si las automatizaciones no tienen condiciones de contención, el riesgo operacional aumenta.
Para entender mejor la confiabilidad, conviene describir cada capa en términos de su función y sus “fallas típicas”. Por ejemplo, en orquestación de mando el riesgo no es solo “que el sistema no funcione”, sino que funcione mal: transiciones de estado incorrectas por ambigüedad en reglas, o flujos que quedan colgados porque una condición nunca se cumple. En integración, el riesgo es la discrepancia semántica: el Commander cree que un evento significa A, pero el sistema fuente lo emitió como B. En automatización, el riesgo es la acción irreversibles: iniciar procesos sin validación suficiente, o ejecutar con parámetros corruptos. En observabilidad, el riesgo es la opacidad: cuando ocurre un incidente, nadie puede reconstruir la cadena de decisiones. Y en gestión de cambios, el riesgo es la degradación gradual: cambios que parecen pequeños y que, al cabo de semanas, rompen supuestos operativos.
Por eso, la arquitectura debe incluir mecanismos como colas robustas, manejo de idempotencia (acciones seguras frente a duplicación de eventos), control transaccional cuando aplique, y estrategias de consistencia. En un Commander Hibrido, la consistencia no es solo un tema de base de datos: es un tema de coherencia operativa. Si los estados en el tablero difieren de los estados en el sistema de ejecución, el personal pierde confianza y se incrementan los retrabajos manuales.
Además, la confiabilidad debe evaluarse en escenarios no ideales. Un sistema híbrido debe contemplar:
- Fuentes intermitentes (datos que llegan tarde o no llegan).
- Eventos duplicados o reordenados (común en sistemas distribuidos).
- Reglas que cambian por gobernanza, auditoría y versión.
- Acciones parciales (comienza un proceso y falla a mitad).
En otras palabras: el Commander Hibrido debe estar pensado para el mundo real, donde el caos no es una excepción sino una condición frecuente.
Seguridad operacional y resiliencia: requisitos que no conviene negociar
En entornos donde un Commander Hibrido afecta decisiones y coordinación, la seguridad no se limita a ciberseguridad; también incluye seguridad funcional, continuidad y gestión de riesgos. Un buen enfoque incluye:
- Principio de mínimo privilegio por rol (operador, supervisor, técnico).
- Segregación de funciones (quién aprueba vs. quién ejecuta).
- Controles de integridad (validación de entradas, verificación de estados).
- Plan de recuperación ante fallas (reintentos, colas, degradación controlada).
- Auditoría completa: qué ocurrió, cuándo, con qué configuración y quién autorizó.
Además, conviene exigir documentación técnica: políticas de seguridad, matrices de permisos, guías de operación y criterios de aceptación para cada fase de despliegue.
Sin embargo, es frecuente que el enfoque de seguridad quede reducido a “tener autenticación” y “usar accesos por usuario”. Eso es necesario, pero no suficiente. En un Commander Hibrido, la seguridad también depende de cómo se implementan las reglas y cómo se maneja el contexto. Por ejemplo:
- Si una regla decide ejecutar una acción, ¿qué validaciones realiza antes?
- Si los datos llegan incompletos, ¿el sistema se detiene (fail-safe) o continúa con valores por defecto?
- Cuando una acción falla, ¿hay mecanismos de compensación o rollback?
- ¿Se registran las razones de decisión (no solo el resultado)?
La resiliencia, por su parte, no debe entenderse solo como “alta disponibilidad”. También implica que el sistema sepa operar con degradación. Por ejemplo, si una integración secundaria falla, ¿el Commander sigue funcionando en modo limitado o queda inutilizable? Una resiliencia madura ofrece:
- Degradación controlada: capacidades reducidas pero comportamiento predecible.
- Reintentos con política: no reintentar sin límites (lo cual empeora la situación), sino con backoff y control de carga.
- Colas y buffer: absorber picos de eventos y mantener orden lógico o idempotencia.
- Recuperación verificable: al volver la integración, se reconcilian estados.
Un punto crítico: la resiliencia debe verificarse con pruebas que simulen fallas. No basta con que el proveedor “prometa” tolerancia. La organización debe diseñar pruebas de caos controlado: desconectar una fuente, introducir retrasos, corromper un dato (en un entorno de prueba) y observar el resultado.
Compatibilidad e integración: el “costo oculto”
En implementaciones de Commander Hibrido, la integración suele ser el componente con mayor variabilidad. No porque sea imposible, sino porque cada organización arrastra particularidades: formatos de datos, calidad de registros, nomenclaturas internas, dependencias con proveedores, y diferencias entre procesos “según manual” y “según operación diaria”.
Por ello, el análisis profesional debe evaluar:
- Calidad y normalización de datos: consistencia de identificadores, estados y eventos.
- Mapeo de procesos: correspondencia entre reglas existentes y reglas del comandante.
- Latencias y sincronización: si los eventos llegan tarde o en orden diferente, la toma de decisiones puede sesgarse.
- Gestión de integraciones: versiones, contratos de datos y monitoreo.
Un Commander Hibrido puede ser tecnológicamente sólido y aun así fallar en adopción si la integración no contempla la realidad del flujo de trabajo.
Para comprender el “costo oculto”, conviene mirar cómo se producen los fallos en integración. Usualmente emergen en uno de estos patrones:
- Semántica distinta: por ejemplo, “aprobado” en un sistema no coincide con “aprobado” en otro (puede ser aprobado condicionalmente, o con diferentes criterios).
- Granularidad desigual: un sistema emite eventos por unidad, otro por lote, otro por tarea; el Commander necesita traducir.
- Modelos de estado diferentes: un sistema tiene cinco estados, otro tiene diez; el Commander debe mapearlos y manejar transiciones no triviales.
- Reconciliación inexistente: el Commander asume que el evento es suficiente, pero en realidad se necesita consultar el estado actual para decidir.
- Dependencias en cadena: una integración depende de otra que depende de otra; si falla la cadena, el Commander puede quedar a la espera indefinidamente.
La compatibilidad, además, implica considerar la coexistencia. ¿Cómo se comporta el Commander si un sistema fuente se renombra, actualiza su API o cambia el formato de un campo? Sin una estrategia de versionado y compatibilidad hacia atrás, la plataforma se vuelve costosa de mantener. Por ello, una evaluación seria exige:
- Contratos de integración documentados (esquemas de eventos, campos obligatorios, validaciones).
- Políticas de cambio (de qué manera se notifica, prueba y despliega un cambio en el sistema fuente).
- Monitoreo de integraciones como primera clase: no solo “up/down”, sino latencia, tasa de errores, volumen de eventos y colas acumuladas.
- Herramientas de reconciliación: procesos para corregir estados cuando exista divergencia.
El “costo oculto” no es únicamente el esfuerzo técnico; es también el costo organizacional. Integrar un Commander Hibrido implica alinear definiciones entre equipos. Si el equipo de operación define un estado de manera y el equipo de TI lo define de otra, el sistema termina reflejando la discrepancia y genera fricción.
Rendimiento y operación diaria: cómo medir sin especular
Es común que las ofertas comerciales incluyan promesas de desempeño. Sin embargo, desde una postura objetiva, lo correcto es hablar de métricas verificables y de pruebas controladas. Para ello, se recomienda definir previamente:
- Tiempos de respuesta del flujo crítico (aprobación, ejecución, actualización de estado).
- Disponibilidad objetivo durante ventana de operación.
- Tasa de error en validaciones y en transiciones de estado.
- Capacidad de escalamiento: comportamiento al aumentar eventos o usuarios.
Si se requieren referencias de mercado o desempeño agregado, lo recomendable es basarse en informes de organismos y consultoras reconocidas (por ejemplo, estudios de disponibilidad y resiliencia elaborados por entidades del sector TI). En ausencia de cifras específicas proporcionadas aquí, el enfoque apropiado es gestionar el riesgo con pruebas de aceptación y evidencias de laboratorio/piloto.
Medir rendimiento en un Commander Hibrido no es solo un asunto de latencia promedio. La operación se ve afectada especialmente por la cola de latencias: percentiles altos (P95, P99). Un sistema con buen promedio pero mala cola puede ser inaceptable. Por ejemplo, si el 80% del tiempo tarda 100 ms pero el 20% tarda 3 segundos, el flujo humano se vuelve inestable: el operador desconoce si está esperando el sistema o si algo “se colgó”.
También importa el rendimiento bajo diferentes patrones de carga:
- Picos de eventos (burst traffic): cuando llegan muchas solicitudes al mismo tiempo.
- Eventos irregulares: cuando la tasa varía de forma impredecible.
- Escenarios de reintentos: cuando una integración falla y el sistema reintenta.
- Escenarios de actualización de reglas: cuando se despliegan cambios y hay recalculo de reglas o migraciones.
Por eso, en el plan de pruebas conviene definir:
- Flujo crítico: qué proceso representa el riesgo mayor o el mayor volumen.
- Métrica de aceptación: no solo “tiempo”, sino “tiempo con condiciones” (con fallas parciales, con integraciones lentas, etc.).
- Simulación realista: datos representativos, no generados de forma simplista.
Una forma práctica de abordar el rendimiento sin especular es convertir el problema en un experimento: definir un set de casos, ejecutar repetidamente con variantes de carga y medir el comportamiento. Lo que se busca es un “mapa” del desempeño: cómo se degrada en condiciones adversas y en qué punto deja de ser aceptable.
Estrategia de adopción: de la prueba controlada a la operación estable
Una adopción madura de un Commander Hibrido suele seguir un patrón de progresión:
- Piloto con alcance limitado y reglas claras.
- Validación con criterios de aceptación medibles (funcionalidad, trazabilidad, recuperabilidad).
- Gestión del cambio (capacitación, documentación, guías de excepción).
- Escalado por etapas, ajustando solo lo necesario.
La clave es minimizar el “salto” desde un estado operativo conocido hacia uno nuevo sin margen. La transición debe permitir aprender: qué datos fallan, qué reglas requieren ajuste, dónde aparecen fricciones humanas (por ejemplo, en la interpretación de eventos o en el flujo de aprobación).
Un piloto exitoso no debe ser un “demo”. Debe ser un ensayo operativo con escenarios reales y verificaciones. En ese contexto, conviene preparar:
- Lista de escenarios normal (casos típicos) y adversos (casos de fallo, datos incompletos, reintentos).
- Estándares de registro (qué logs se deben generar y cómo se correlacionan).
- Procedimiento de escalamiento en incidentes (quién toma decisiones y cómo se detiene una automatización).
- Plan de reversión (qué se revierte, en qué orden, con qué verificación).
En un Commander Hibrido, la gestión del cambio incluye al menos tres grupos: (1) operación diaria, (2) supervisión/gestión de incidentes, y (3) soporte técnico. Cada uno debe entender su rol en el “ciclo de vida operativo”. Una capacitación genérica suele fallar porque el sistema requiere que la gente sepa interpretar señales: alarmas, estados, causas probables y trazas de auditoría.
Además, es útil definir “criterios de excepción” con lenguaje operativo. Por ejemplo: en vez de decir “cuando el sistema esté degradado”, se define “cuando P99 exceda X segundos durante Y minutos” o “cuando fallan 3 integraciones consecutivas”. Estas reglas permiten que la organización reaccione con consistencia, en vez de improvisar bajo presión.
Comparación técnica (sin enlaces) y guía complementaria de requisitos
Para facilitar la evaluación, a continuación se presenta un comparativo de enfoque y condiciones típicas al evaluar un Commander Hibrido en organizaciones que requieren mando, coordinación y automatización controlada.
| Aspecto | Enfoque recomendado | Condición/Resultado esperado |
|---|---|---|
| Arquitectura híbrida | Separación clara entre orquestación, automatización y observabilidad | Transiciones auditables y comportamiento predecible ante cambios |
| Integración | Contratos de datos, mapeos explícitos y normalización | Menos fallas por discrepancias semánticas entre sistemas |
| Seguridad | Principio de mínimo privilegio y auditoría por rol | Rastreo de acciones y reducción del riesgo por accesos indebidos |
| Resiliencia | Recuperación ante fallas y degradación controlada | Continuidad operativa durante incidencias parciales |
| Operación y mantenimiento | Procedimientos de monitoreo, alertas y gestión de cambios | Top tiempo de diagnóstico (MTTR) y menos interrupciones |
| Gobernanza | Flujos de aprobación y reglas de excepción | Coherencia entre decisiones automatizadas y criterio humano |
Ese comparativo resume direcciones, pero en una evaluación real es necesario descender a detalles. Por ejemplo, “auditoría por rol” no es un enunciado abstracto: implica campos en logs (usuario, rol, acción, parámetros, razón, correlación con eventos y versión de reglas). De igual manera, “contratos de datos” debe traducirse en esquemas, versiones, y pruebas de compatibilidad. La guía complementaria debería incluir además la gestión de errores y el modelo de estados, porque es donde los sistemas fallan en condiciones de borde.
Modelo de estados y transiciones: el corazón del Commander Hibrido
Una dimensión esencial que a menudo se subestima es el modelo de estados. Un Commander Hibrido debe manejar entidades (tareas, órdenes, flujos de trabajo, recursos) a través de un ciclo de vida. Ese ciclo se expresa como estados y transiciones. Si este modelo es débil, el resto de la plataforma se vuelve frágil.
Para evaluar un modelo de estados, conviene formular preguntas concretas:
- ¿Existen estados terminales claros (completado, cancelado, fallido)?
- ¿Hay estados intermedios que reflejen operaciones reales (pendiente de datos, en verificación, en ejecución)?
- ¿Qué sucede cuando un evento llega para una entidad en un estado inesperado?
- ¿Cómo se validan las transiciones (guard conditions) antes de ejecutar acciones?
- ¿El sistema soporta reintentos sin duplicar efectos (idempotencia)?
Un modelo robusto evita transiciones inconsistentes y reduce el riesgo de “corrupción lógica”. En sistemas híbridos, el error más peligroso no siempre es el crash: a veces es el error silencioso, cuando el sistema avanza a un estado que parece correcto, pero que es incorrecto a nivel de negocio. Por ello, el modelo de estados debe conectarse con reglas de validación y con auditoría.
Otra característica crítica es el manejo de excepciones. En un flujo real, ocurren interrupciones: falta de un recurso, falla temporal de un servicio, inconsistencia en datos, o una decisión de excepción que requiere criterio humano. Un Commander Hibrido debe tener un diseño de excepción que:
- Permita detener automatizaciones de forma controlada.
- Defina a quién notificar y en qué momento.
- Registre el motivo y la evidencia (por ejemplo, qué validación falló).
- Ofrezca caminos de recuperación (reintentar, corregir datos, escalar).
Cuando no existe este diseño, la operación se llena de “trabajo invisible”: el personal termina corrigiendo manualmente, pero el sistema no queda con el conocimiento de por qué ocurrió el incidente. Esa pérdida de aprendizaje incrementa el costo operativo a lo largo del tiempo.
Gobernanza de reglas: versionado, trazabilidad y control
La hibridación implica que el sistema contiene reglas. Esas reglas pueden ser configurables o codificadas; en cualquier caso, son un activo crítico. Por ello, la gobernanza de reglas debe estar definida. Si no, el Commander Hibrido se convierte en una caja negra difícil de auditar y mantener.
La gobernanza debería cubrir:
- Versionado de reglas: cada cambio debe tener un identificador de versión y un historial.
- Aprobación: quién puede editar reglas, quién aprueba y quién despliega.
- Reversión: mecanismo para volver a una versión anterior sin romper el flujo.
- Compatibilidad: cómo afecta una nueva regla a entidades ya en curso.
- Observación: cómo se mide el efecto de una regla en métricas operativas (tasa de error, tiempos, escalaciones).
Un error frecuente es tratar las reglas como “configuración simple”. Pero en un Commander Hibrido, una regla puede modificar el comportamiento global. Por ejemplo, si una condición de validación cambia, puede aumentar el volumen de aprobaciones manuales o disparar acciones automáticas fuera de secuencia. La gobernanza transforma la modificación de reglas en un proceso controlado y auditado, no en un acto improvisado.
La trazabilidad también debe incluir el contexto: cuando el sistema toma una decisión, debería registrar qué versión de reglas aplicó, qué eventos recibió y qué validaciones completó. Sin esto, la auditoría se vuelve un ejercicio superficial.
Automatización controlada: cuándo automatizar y cuándo contener
En un Commander Hibrido, la automatización no es un “sí o no”. Es una estrategia de asignación: qué parte del flujo se ejecuta automáticamente, con qué límites, y qué parte se deja a supervisión humana. Diseñar esto bien significa traducir el riesgo de negocio en criterios técnicos.
Un enfoque razonable para decidir el nivel de automatización incluye tres dimensiones:
- Riesgo de acción: impacto de ejecutar algo incorrectamente.
- Calidad de información: si hay datos suficientes y confiables para decidir.
- Reversibilidad: si la acción puede deshacerse o compensarse.
Por ejemplo, acciones de alto riesgo o con baja reversibilidad suelen requerir aprobación humana (o al menos un “doble chequeo”). Acciones repetitivas con datos consistentes y reversibles pueden automatizarse con más libertad. La hibridación, entonces, se vuelve una forma de gestión del riesgo: automatizar donde el costo del error es bajo y contener donde el costo es alto.
Además, automatizar no significa “ejecutar sin esperar”. Un sistema robusto usa:
- Validaciones pre-ejecución: comprobar integridad y contexto.
- Validaciones post-ejecución: confirmar que el efecto real ocurrió.
- Idempotencia y deduplicación: evitar ejecuciones duplicadas.
- Límites de frecuencia: evitar que un bucle de fallas dispare muchas acciones.
Es común que una automatización “funcione” en el laboratorio y falle en producción por casos de borde. Por ello, el diseño de contención debe incluir un estado “en espera de intervención” y un mecanismo de notificación eficaz.
Observabilidad y auditoría: la diferencia entre “falló” y “por qué falló”
La observabilidad es la capacidad de entender el sistema con evidencia. En un Commander Hibrido, es crucial porque la plataforma participa en decisiones coordinadas. Si ocurre un incidente, la organización necesita reconstruir la cadena: evento → reglas → validaciones → acciones → resultados → impactos en estado.
Una observabilidad madura contempla:
- Logs correlacionados (trazabilidad end-to-end).
- Métricas (latencia, tasa de error, volúmenes de eventos, profundidad de colas).
- Trazas (para seguir el flujo de una entidad por múltiples componentes).
- Alarmas útiles (no solo “todo está caído”, sino “está ocurriendo X en Y condiciones”).
La auditoría, por otro lado, se enfoca en “qué ocurrió y quién autorizó”. Debe incluir:
- Usuario/rol que inició o aprobó.
- Fecha/hora y zona horaria.
- Acción ejecutada y parámetros relevantes (sin exponer datos sensibles).
- Versión de reglas y configuración aplicadas.
- Evidencia: por qué el sistema decidió o por qué falló una validación.
Un problema típico en sistemas híbridos es que el tablero muestra el resultado final, pero no ofrece la evidencia que permite explicar el resultado. Esto obliga a los equipos a “investigar a mano” y aumenta el tiempo de diagnóstico (MTTR). Por eso, al evaluar un Commander Hibrido, se debe pedir cómo funciona la observabilidad en incidentes: ¿se pueden ver los motivos de una transición? ¿se puede rastrear una acción hasta la regla? ¿hay herramientas de exportación para análisis?
Además, la observabilidad debe diseñarse considerando la privacidad y la seguridad. No se trata de registrar todo indiscriminadamente: se registra lo necesario para diagnosticar y auditar, aplicando políticas de redacción o minimización de datos.
Operación, mantenimiento y sostenibilidad del ciclo de vida
El mantenimiento es donde muchos Commander Hibrido se vuelven costosos o riesgosos. Por eso, no se debe evaluar solo la fase de despliegue; se debe evaluar la sostenibilidad operativa: cómo se monitorea, cómo se corrige, cómo se actualiza y cómo se previenen regresiones.
Un enfoque profesional incluye:
- Procedimientos de monitoreo: qué indicadores se revisan, con qué frecuencia y con qué umbrales.
- Gestión de alertas: alarmas sin ruido excesivo (evitar fatiga por alertas).
- Playbooks de incidentes: pasos claros para responder, mitigar y restaurar.
- Gestión de cambios: ventanas de mantenimiento, pruebas y reversión.
- Pruebas de regresión cuando se actualizan reglas o integraciones.
La sostenibilidad también depende de la mantenibilidad del sistema por parte del equipo interno. Si toda modificación requiere intervención del proveedor, el costo de operación aumenta y se reduce la agilidad. Sin embargo, permitir cambios ilimitados también es un riesgo; por eso, el equilibrio está en un modelo de gobernanza y en interfaces de configuración controladas, con validaciones y pruebas.
Otra dimensión es la dependencia de integraciones. Si el Commander Hibrido depende de servicios de terceros, se debe evaluar la estrategia de mantenimiento: monitoreo de APIs, contratos, versiones y plan de migración cuando los proveedores cambian. La integración debe ser un “sistema vivo” con vigilancia, no un proyecto “one-shot”.
En un entorno bien gobernado, el Commander Hibrido se vuelve una plataforma que mejora con el tiempo: se ajustan reglas, se refinan excepciones, se corrigen mapeos de datos y se aprende de incidentes. En un entorno mal gobernado, el sistema se convierte en un mosaico de parches que funcionan localmente pero deterioran la coherencia global.
Fuente, pasos y condiciones (guía de implementación paso a paso)
Fuente: metodología basada en prácticas estándar de ingeniería de sistemas, gobierno de cambios y gestión de riesgos operacionales utilizadas en auditorías técnicas y proyectos de integración en entornos empresariales. Como no se proporcionan precios, proveedores específicos ni ubicaciones concretas en el encargo, el documento se centra en criterios de evaluación y requisitos funcionales verificables.
- Definir el alcance del Commander Hibrido: qué procesos coordina y qué acciones automatiza.
- Mapear reglas de negocio: convertir procedimientos actuales en reglas operativas con excepciones.
- Diseñar el modelo de permisos: roles, aprobaciones, trazabilidad y auditoría.
- Preparar integración: identificar sistemas fuente, calidad de datos, sincronización y esquema de eventos.
- Establecer criterios de aceptación: métricas de respuesta, validación y continuidad.
- Ejecutar pruebas piloto con un subconjunto de escenarios reales, incluyendo casos de fallo.
- Capacitar y documentar: guías de operación, manejo de alarmas y procedimiento ante excepciones.
- Escalar gradualmente: ampliar cobertura por etapa, con control de cambios y revisiones.
- Monitorear y optimizar: ajustar reglas basadas en hallazgos del piloto, sin introducir cambios no necesarios.
- Revisión post-implementación: auditoría de trazabilidad, lecciones aprendidas y plan de topa continua.
Condiciones/requirements recomendados para considerar la puesta en operación estable:
- Disponibilidad de logs con correlación de eventos (trazabilidad end-to-end).
- Capacidad de revertir cambios de configuración con mínimo impacto.
- Procedimientos de contingencia documentados y ensayados (simulación de incidentes).
- Revisión de seguridad con roles claramente establecidos y control de accesos.
- Alineación de responsables: quién aprueba, quién ejecuta y quién reporta incidentes.
Riesgos y antipatrones comunes: más allá de la “configuración”
Revisar un Commander Hibrido desde el punto de vista crítico implica detectar riesgos y antipatrones que se repiten en proyectos reales. En el mundo del mando y control híbrido, muchas fallas se originan por decisiones de diseño tempranas, no por errores de operación.
Entre los riesgos y antipatrones más frecuentes se encuentran:
- Automatizar sin límites: el sistema ejecuta acciones sin condiciones de contención y validación suficientes, o con reglas demasiado amplias.
- Reglas ambiguas: criterios de decisión que no están definidos con claridad (o cambian sin control), generando interpretaciones inconsistentes.
- Observabilidad insuficiente: el equipo no puede diagnosticar por qué ocurrió una transición o por qué una validación falló.
- Integración fragmentada: parches que funcionan hoy pero rompen mañana al cambiar un sistema, un esquema de eventos o un contrato.
- Dependencia excesiva de la interfaz: el operador “lee” la causa en el tablero, pero la evidencia real está en sistemas que no se consultan fácilmente.
- Falta de simulación de fallas: se prueba solo el camino feliz, sin medir comportamiento bajo escenarios adversos.
- Capacitación incompleta: operadores y supervisores no dominan excepciones ni alarmas; el sistema no se vuelve “operable” aunque funcione.
El antipatrón “automatizar sin límites” suele ser particularmente dañino en entornos donde el costo de un error es alto. Puede ocurrir cuando la organización está ansiosa por reducir tiempos y decide automatizar “para acelerar” sin definir contención. La automatización controlada debería incluir un modo “observación” o “dry-run” al menos en el piloto, donde el Commander evalúa reglas pero no ejecuta acciones irreversibles.
Otro antipatrón es “integración fragmentada”. Cuando cada integración se implementa de manera aislada, el Commander termina con adaptadores ad-hoc. Eso produce un sistema difícil de mantener y con riesgo de regresión: una actualización en un sistema fuente puede romper mapeos en cascada. Una estrategia robusta requiere estandarizar contratos, validaciones y mecanismos de reconciliación.
Recomendaciones del experto: cómo evitar errores comunes
En proyectos donde aparece un Commander Hibrido como eje de coordinación, los errores más repetidos suelen ser de naturaleza organizacional o de diseño, no de “falta de tecnología”. Entre los más frecuentes:
- Automatizar sin límites: acciones automáticas sin condiciones de contención y validación.
- Reglas ambiguas: criterios de decisión que no están definidos con claridad (o cambian sin control).
- Observabilidad insuficiente: el equipo no puede diagnosticar por qué ocurrió una transición.
- Integración fragmentada: parches que funcionan hoy pero rompen mañana al cambiar un sistema.
- Falta de entrenamiento: operadores y supervisores no dominan excepciones ni alarmas.
La solución no siempre implica “hacerlo más complejo”; a menudo requiere hacerlo más verificable y más coherente con el flujo real de trabajo.
Para materializar esa recomendación, el enfoque experto suele incluir medidas concretas como:
- Revisión de reglas con un procedimiento formal (dueño de proceso, validación técnica y aprobación).
- Definición de “contratos de datos” y pruebas de compatibilidad antes de despliegues.
- Diseño de estados y transiciones con guardas y validaciones, evitando estados “improvisados”.
- Playbooks de incidentes basados en indicadores reales (qué alarma, qué medir, qué hacer).
- Pilotos con casos de fallo y métricas de aceptación que incluyan degradación controlada.
Un enfoque que suele generar resultados rápidos es incorporar al piloto la capacidad de “explicar” decisiones. Si el sistema permite mostrar al operador (o al auditor) la razón por la que se ejecutó una acción o por la que se solicitó aprobación, la adopción mejora. El personal deja de sentir que la plataforma “actúa” y empieza a entenderla como un motor de reglas.
Preguntas frecuentes (FAQs)
1) ¿Qué diferencia al Commander Hibrido de un sistema de mando tradicional?
La diferencia principal radica en que un Commander Hibrido integra coordinación con automatización y/o integración técnica, buscando consistencia operativa y trazabilidad. Un mando tradicional puede depender más de interacción humana y procedimientos manuales; en cambio, el enfoque híbrido administra transiciones, reglas y ejecución controlada.
2) ¿El Commander Hibrido elimina la necesidad de supervisión humana?
No necesariamente. Un diseño robusto suele mantener supervisión y aprobaciones para acciones críticas. La automatización se introduce con límites, validaciones y flujos de excepción para que el criterio humano se mantenga donde el riesgo lo exige.
3) ¿Qué documentación debería exigir antes del despliegue?
Como mínimo, guías de arquitectura, modelo de permisos, criterios de auditoría (qué se registra y cómo), procedimientos de recuperación ante fallas, y documentación de integración (contratos de datos, mapeos de eventos y dependencias).
4) ¿Qué riesgos son más comunes en la adopción?
Entre los más comunes están la ambigüedad de reglas, la falta de observabilidad, la integración incompleta (datos inconsistentes), y la ausencia de un plan de contingencia ensayado. También puede fallar la adopción si el equipo no entiende cómo operar excepciones.
5) ¿Cómo se valida que el Commander Hibrido funciona correctamente?
Mediante pruebas piloto con escenarios reales y criterios de aceptación medibles: tiempos de respuesta, calidad de decisiones (según reglas), trazabilidad de eventos y capacidad de recuperación ante fallas. Las validaciones deben incluir casos normales y casos de error.
6) ¿Hay requerimientos de seguridad específicos?
Sí. Enfoques recomendados incluyen mínimo privilegio por rol, auditoría completa, segregación de funciones (aprobación vs. ejecución) y controles de integridad. Además, conviene revisar el modelo de actualización y reversión para evitar degradaciones inesperadas.
7) ¿Cómo afecta el mantenimiento a la sostenibilidad del sistema?
El mantenimiento debe estar integrado al ciclo de vida: monitoreo continuo, gestión de cambios con versionado, y procedimientos de diagnóstico. Un Commander Hibrido sostenible reduce el tiempo de diagnóstico y minimiza interrupciones mediante prácticas de ingeniería y operación maduras.
Conclusión: evaluación profesional, no solo elección tecnológica
El Commander Hibrido puede convertirse en un componente decisivo para organizaciones que requieren coordinación, automatización controlada y trazabilidad. No obstante, su éxito depende de criterios verificables: arquitectura clara, integración confiable, seguridad operacional, observabilidad y una estrategia de adopción por etapas con pruebas de aceptación.
Si se desea avanzar, el siguiente paso razonable es elaborar un documento de evaluación interno con el alcance del proceso, los flujos de aprobación, los sistemas a integrar y los criterios de aceptación del piloto. Con esa base, la decisión deja de ser puramente tecnológica y se vuelve realmente operativa.
-
1

A Guide to Cost-Efficient Small Electric Cars for Seniors
-
2
Mastering Debt Consolidation: Boost Your Credit Score and Manage Interest Rates
-
3
Your Guide to Loans, Credit Checks, and Interest Rates
-
4
Affordable Independent Living: Finding the Right Senior Housing
-
5
Guide to Senior Living Apartments: Affordable and Comfortable Environments